2026年9月4日,华为半导体负责人何庭波在中国科学院科技论文预发布平台ChinaXiv发表更新论文《华为τ芯片本该过热烧毁?》,首次以量产芯片麒麟2026的逐模块实测数据,回应了自τ定律发布以来业界对3D堆叠散热问题的核心质疑。这份数据呈现了一个看似违反物理直觉的结果,晶体管密度提升55%的同时,NPU功耗下降66%、GPU下降58%、CPU大核下降41%。在高密度与低功耗长期被半导体行业视为不可兼得的两个方向上,华为的实测数据指向了一条绕开EUV光刻微缩的替代路径。
从空间缩放到时间缩放
传统摩尔定律的底层逻辑是几何缩微,通过缩小晶体管尺寸、提高单位面积堆叠数量来提升性能。这条路线依赖EUV极紫外光刻设备持续推进制程节点。华为因外部条件限制无法获得先进光刻工具,被迫跳出空间缩放的固有路线,转向压缩信号在芯片内部传输的特征延迟τ(韬),由此提出τ缩放定律。
τ缩放定律的核心洞察并不复杂。何庭波在论文中用一个形象的比喻点明芯片能耗的本质,一个人在工作日消耗的能量,并非主要来自坐在办公桌前工作的那几小时,通勤同样需要消耗大量能量。芯片也是如此,晶体管完成逻辑运算固然耗能,但数据在模块和电路之间长距离传输同样吞噬着动态功耗。根据论文披露的数据,在典型智能手机工作负载中,动态功耗约占总功耗的90%,而随着制程微缩,互连电容带来的传输能耗愈发沉重。
芯片内部真正昂贵的代价并非晶体管在思考,而是数据在金属走线中的通勤。把芯片比作一座城市,平面布局的电路架构相当于一座扁平蔓延的都市,信号需要跨区域长距离行驶,大量能耗和时间损耗在路上。τ缩放定律的思路,是把这座城市从摊大饼式平面布局改建为紧凑的立体结构,让信号从水平长途跋涉变成垂直短途直达。
逻辑折叠的工程实现
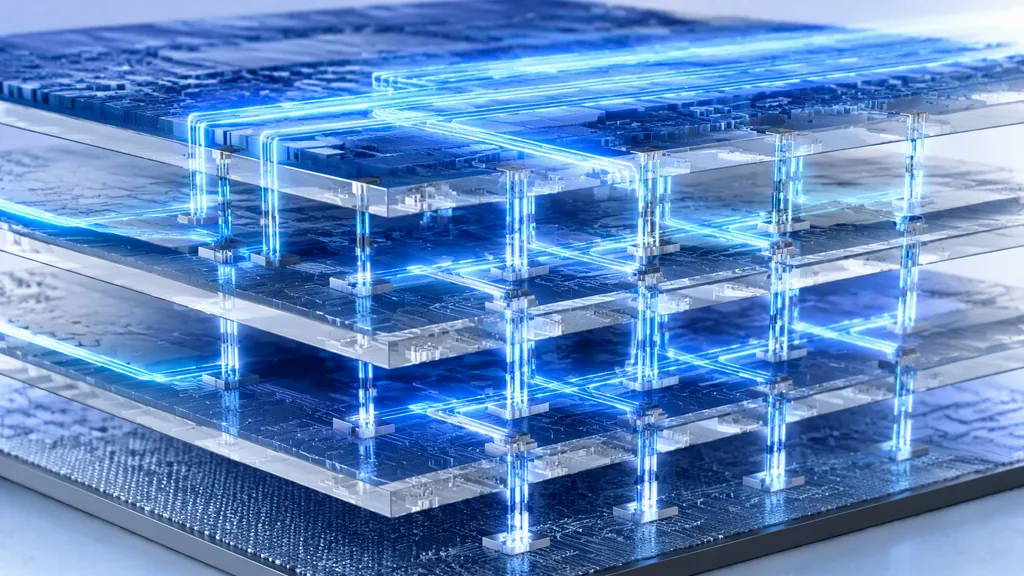
τ缩放定律的核心落地技术是逻辑折叠(LogicFolding)。该技术依托3D混合键合工艺,将原本平铺在一层的电路拆分重构为垂直堆叠的多层结构,通过微米级垂直互连桥接各层电路。
具体到麒麟2026芯片,逻辑折叠采用40纳米级键合工艺实现了1.5微米键合间距,每平方毫米约50万个垂直互连,全芯片共计约5000万根垂直互连。这种密集的垂直互连使得信号不再沿水平金属走线长途跋涉,而是通过垂直短距路径直达。论文披露的实测数据显示,典型核心走线长度缩短约20%,部分关键路径缩短达70%;某处理模块的时钟布线缩短28%,时钟缓冲器数量从4.36万个降至1.9万个。
走线缩短带来的直接收益是互连电容降低。互连电容与走线长度成正比,而动态功耗又与电容成正比。更短的走线意味着更低的电容负载,进而意味着更低的开关功耗。这就像缩短了水管长度,水流过程中的摩擦损耗自然减少。
麒麟2026的实测数据佐证了这条因果链。在相同性能条件下,NPU保持29TOPS算力不变,工作频率降低63%,电压从0.85V降至0.55V,功耗密度下降73%。动态功耗与电压的平方成正比,电压从0.85V压到0.55V,仅此一项理论功耗降幅就超过58%。
并非万能钥匙的折叠
何庭波在论文中并未将逻辑折叠描绘成自动节能的捷径。她明确指出,τ是时间缩放定律而非能量缩放定律。折叠带来的本质收益是时间余量,信号传输更快,完成同样计算所需的时间更短,从而允许降低工作频率和电压以节省功耗。但如果设计者将节省的时间全部用于提升频率而非降低功耗,芯片反而可能更耗电。
麒麟2026上的DSP模块提供了反面案例。第一代折叠后,DSP总功耗降低25%,但芯片面积同时缩小40%,导致单位面积功率密度反而上升24%。这说明折叠技术本身并不保证低温,关键在于设计者如何分配折叠带来的余票。何庭波将其形容为,你可以选择换低温,也可以选择换性能,二者不可自动兼得。
麒麟2026的Turbo模式就是选择换性能的实例。在该模式下,NPU算力飙升至70TOPS,较前代提升141%,此时芯片温度自然也不会客气。另一方面,CPU因任务串行性强、难以靠并行阵列获益,其折叠收益远逊于NPU和GPU,功耗仅下降41%。
热感知布局也是维持低温的重要配合手段。麒麟2026刻意让高温模块和低温模块交错排布,避免发热大户上下层叠加形成热点。这是一项系统工程而非单一技术突破,折叠提供了优化空间,但最终温控效果取决于设计者如何在性能、面积和功耗之间做出取舍。
互连精度的新赛道
τ缩放定律将性能提升与光刻制程部分解耦,直接改变了产业价值池的分布。当晶体管密度不再单纯依赖EUV光刻的几何微缩,而是可以通过3D互连密度提升来实现,互连精度就取代制程节点成为新的竞争主轴。
论文披露的三维互连间距路线图给出了清晰信号,麒麟2026采用1.5微米键合间距、5000万垂直互连,基于成熟的40纳米工艺实现;下一代麒麟2027将间距收窄到1.0微米,垂直互连超过1亿根;三年内对齐720纳米顶层金属布线间距,互连超过2亿根;远期目标看向480纳米。
这条路线图的产业含义在于,它绕开了当前最尖端的EUV光刻设备瓶颈,转而在先进封装和3D混合键合领域开辟新的密度增长曲线。快思慢想研究院院长田丰对此评价称,这是华为芯片技术路线从论文推演走向量产验证的一次关键跨越,也是判断一项工艺路线是实验室成果还是产业级路线的分水岭。
产业格局的深层影响
华为τ缩放定律的量产验证,在后摩尔时代半导体产业中投下了一枚深水炸弹。其冲击力不在于单颗芯片的性能数字,而在于它证明了密度增长可以不依赖制程微缩。
台积电CoWoS先进封装产能持续紧张,ABF载板交期从6至8个月拉长到12至14个月,全球Chiplet用量预计从2025年的约18.6亿颗增长至2030年的257亿颗,先进封装市场从540亿美元增长至2031年的约1086亿美元。这些数据指向同一个趋势,先进封装和3D互连正在从芯片产业的后端配角走向前端主战场。
华为在τ缩放路线上的验证,意味着在EUV光刻这条传统制程赛道之外,3D混合键合和逻辑折叠正在成为并行的密度增长路径。对于同样面临先进光刻获取限制的芯片厂商而言,这条路径的工程可行性已经得到量产级数据的验证。而互连间距从1.5微米到480纳米的迭代节奏,将决定这条替代路线能走多远、能追到多高。
何庭波在论文结尾引用了西西弗斯的神话。这个比喻指向的或许是整个半导体行业的处境,无论是制程微缩还是3D折叠,每一代都需要把巨石推向更高的山巅,而下一代芯片永远是下一颗需要推动的巨石。τ缩放定律提供了一面新的山坡,巨石仍在向上。