2026年8月25日,Hot Chips 2026大会现场,英伟达宣布Groq 3 LPX推理加速机架全面投产。这标志着英伟达以200亿美元收购Groq后,首次将其语言处理单元(LPU)架构纳入主流AI算力产品线。Groq 3 LPX是一套与Vera Rubin GPU协同工作的专用推理加速器,核心设计目标只有一个,在AI智能体场景下把Token生成速度推到传统GPU架构难以触及的水平。
为什么GPU在推理端开始力不从心
过去几年,AI算力几乎等同于GPU算力。从H100到B200再到Rubin,GPU同时承担训练和推理两个场景。但大模型走向大规模应用后,推理侧的需求特征与训练截然不同。训练阶段需要高密度矩阵运算和大规模数据吞吐,GPU的并行架构天然适配;推理阶段则分为Prefill(预填充)和Decode(解码)两个子阶段,前者处理输入上下文,后者逐Token生成输出,两者的计算特征差异显著。
英伟达在Hot Chips上展示的数据揭示了问题的核心。Agentic系统消耗的Token数量可达传统AI应用的15倍。智能体完成一项任务可能需要连续数十次模型调用,每次调用都要反复处理大量上下文及此前累积的状态信息,延迟随工作流程逐步叠加。传统GPU在解码阶段受限于HBM(高带宽内存)访问延迟和缓存未命中风险,难以同时兼顾高吞吐和低延迟。
如果把GPU比作一辆功能齐全的通用卡车,能拉货也能越野,LPU则更像一条固定轨道上的高铁,路线提前铺好,不需要临时调度,速度因此能拉到极限。
LPU与GPU的架构分野,SRAM对决HBM
Groq 3 LPU的架构哲学与GPU几乎相反。它不依赖外部HBM,而是将大规模SRAM(静态随机存取存储器)直接铺在计算核心旁边。单颗LPU集成500MB片上SRAM,带宽达150TB/s,是Vera Rubin GPU(22TB/s)的近7倍。数据访问延迟降至纳秒级,而GPU通过HBM访问数据的延迟通常在百纳秒量级。
但容量是LPU的硬约束。GPU可装载80GB以上模型权重,单颗LPU仅能容纳约230MB。运行大模型必须将数百颗LPU串联协同工作,这正是LPX机架设计的出发点。一个完整LPX机架集成256颗Groq 3 LPU芯片,片上SRAM合计128GB,SRAM带宽40PB/s,扩展带宽640TB/s,提供315 PFLOPS的FP8推理算力。整套系统采用MGX模块化架构与全液冷设计。
制造端有一个值得关注的细节。Groq 3 LPU交由三星4nm产线代工,而非英伟达长期合作的台积电。对连续亏损四年的三星代工业务而言,这笔订单直接关系到第三季度的财务表现。
确定性执行,从架构特性到工程红利
LPU最核心的设计选择是确定性执行。传统GPU依赖乱序执行和动态硬件调度来适配各种工作负载,灵活性高但执行路径不可预测。LPU则采用确定性流处理架构,整个计算和芯片间通信步骤由编译器提前规划到时钟周期,形成静态时序的传送带模式。
这种设计带来一个容易被忽视的工程红利。因为执行路径完全确定,连未来几毫秒的功耗变化都可以预测。电源系统因此能提前准备电流,显著降低电压跌落;软件可以提前分配负载,避免局部热点。确定性从单纯的方便调试升级成了电力和热设计工具。
在芯片间通信层面,Groq 3 LPX实现了细粒度的计算通信重叠。传统推理模式需要等一整块矩阵运算完成再统一传输结果,产生明显的通信尾部等待。LPU将计算拆分为320字节的极小粒度,每计算完一小块就立刻通过芯片间链路发送,实现边算边传。这种模式大幅压缩了总耗时,尤其适合长上下文推理中计算量最大的注意力算子。
GPU与LPU的异构协同,三种分工模式
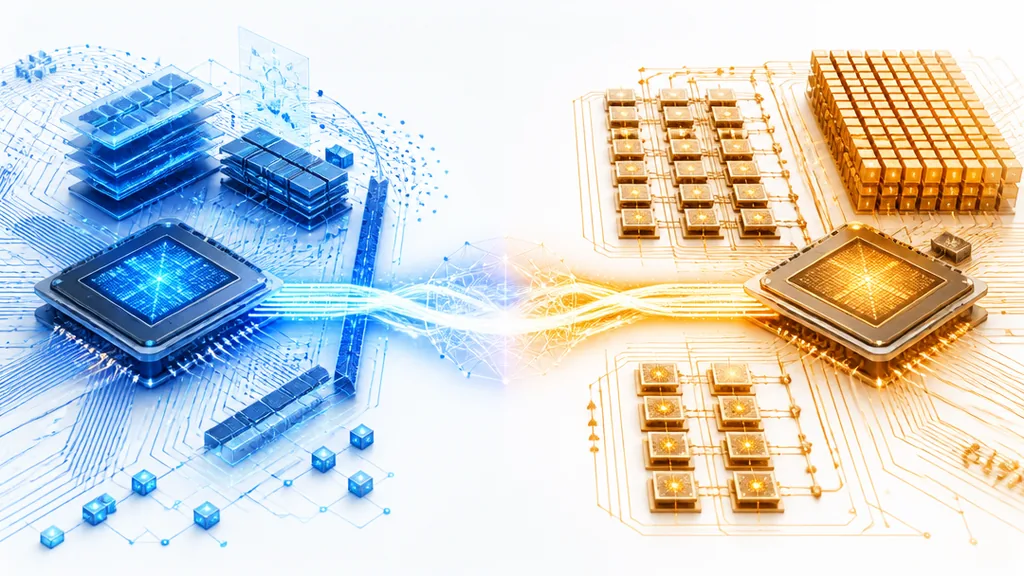
英伟达在Hot Chips上展示了Vera Rubin GPU与Groq 3 LPX的三种协同配置,构成了异构推理架构的核心。
第一种,Prefill-Decode解耦。Rubin GPU负责Prefill阶段,处理大规模上下文输入并生成KV Cache,随后将KV Cache移交给LPX完成完整Decode。GPU专注发挥计算密度优势,LPU专注发挥低延迟解码优势。
第二种,Attention-FFN解耦。Rubin负责Prefill、KV Cache管理和Decode中的注意力计算,LPX负责前馈网络(FFN)和MoE专家层计算。这种分工利用了LPU对确定性数据流的处理能力,将Transformer中最规整的计算部分卸载到LPU上。
第三种,推测解码。LPX运行小型草稿模型快速生成候选Token,Rubin运行大型目标模型进行验证。推测解码依赖草稿模型的高速生成能力,LPU的低延迟特性使其成为理想候选。
实测数据,每秒3400 Token与35倍成本压缩
英伟达公布了一组基准测试数据。在第三方机构Artificial Analysis的测试中,LPX机架运行Gemma 4 31B模型、处理10万Token上下文时,每秒输出3400个Token,响应速度是竞品平台的4倍。
在系统级效能方面,基于SemiAnalysis的AgentX工作负载、采用DeepSeek V4 Pro模型测试,Vera Rubin NVL72搭配LPX后,每兆瓦吞吐量达到上一代GB300 NVL72的30倍,每Token成本最高降低35倍。
这些数据来自英伟达自行选择的测试场景,实际部署中的表现取决于工作负载特征、模型架构和软件栈成熟度。3400 Token/s的数字在10万Token长上下文场景下实现,短上下文场景下的优势可能收窄。
推理算力的产业分化
Groq 3 LPX投产后,AI推理芯片市场的竞争格局正在重塑。AMD宣布将机架级系统与Cerebras芯片整合,主攻低延迟推理。OpenAI的Ultrafast模式由Cerebras提供支持,承诺每秒750个Token。英伟达则通过自研LPU与GPU的异构组合,试图在同一平台内覆盖从训练到推理的完整链条。
黄仁勋在3月的发布会上透露了英伟达内部的算力分配规划。数据中心中四分之一的空间将分配给Groq芯片,其余部署Vera Rubin产品。首批LPX机架已部署于Nebius平台,CoreWeave则部署了Spectrum-X Multiplane来连接多个Vera Rubin机架。
Groq 3 LPX的投产传递了一个信号,AI算力从训练侧的军备竞赛,正在向推理侧的精细化分工转移。GPU不会退出推理市场,其通用性和灵活性仍是优势;但面向智能体时代的高并发、长上下文、低延迟推理需求,专用架构正在切出自己的生存空间。推理算力的多元化,对产业格局的冲击可能比训练算力的集中化更深刻。