谷歌11月9日在官方博客公布了第八代TPU的两套新系统,TPU 8tx与TPU 8i Max。前者面向需要处理敏感数据的政府与受监管行业,把安全机制做进硬件层。后者把两颗8i芯片装进同一个封装,算力、片上SRAM和高带宽内存带宽同步翻倍。加上4月Google Cloud Next上发布的8t与8i,第八代TPU在一年内出现了四种配置。谷歌AI与基础设施高级副总裁兼首席技术官Amin Vahdat在博客中写道,这是谷歌首次在同一个年份推出四款TPU系统。
这两套系统都没有新的硅片。8tx沿用8t的芯片,8i Max是两颗8i的组合,变化发生在封装、内存、网络与安全配置上。
芯片在产线上排队,系统在几个月内交付
Vahdat对芯片与系统做了一次区分。设计一颗新芯片意味着在硅片上排布数十亿个晶体管,受制于物理规律和漫长的制造周期,时间以年计。系统则是围绕芯片组织计算、网络与存储的方式,包括如何封装、配多少内存、接什么网络、放哪一级安全能力。
这个区别可以借用汽车来理解。发动机决定动力上限,但一辆车跑得快不快,还取决于变速箱、底盘和散热。换发动机要重做产线,换底盘和变速箱则能在现有平台上较快完成。谷歌从第一代TPU起就把芯片当作积木,围绕AI Hypercomputer调整封装、高速内存、光网络与安全配置,这次的两款新品正是这套积木思路的产物。
按谷歌披露的数据,4月发布的8t在训练性能上比上一代最高提升2.7倍,8i的推理性价比提升80%。8tx与8i Max没有重做这两颗芯片,只改变了它们所处的系统环境。
8tx把解密后的数据关进硬件
常规加密只覆盖两个环节。数据躺在磁盘上时是密文,经过网络传输时是密文,一旦进入内存交给处理器运算,就必须还原成明文。这条规则对金融、医疗、政府和国防类客户构成持续风险,内存里的明文既可能被同机进程读取,也可能被运维人员看到。
8tx的做法是把安全机制下沉到硬件。它沿用8t的硅片,主机侧换成第五代AMD EPYC处理器,谷歌称敏感数据与模型权重在活跃使用状态下依然保持受保护与隔离。网络侧采用为实时推理设计的Boardfly,多步智能体在工具调用之间往返时,延迟比8t最多降低一半,谷歌同时称性能损失接近于零。
这套设计的价值不只在安全。以往一家机构的敏感数据落在某个集群,做微调、蒸馏或强化学习训练就要在集群之间搬数据,每搬一次都是一次合规审批。8tx把训练级算力与推理网络放进同一套系统,团队可以在原地用私有数据微调模型、把大模型蒸馏成小模型、用强化学习训练智能体,敏感数据不必出集群。对合规部门来说,数据不出域从一个流程约束变成了架构约束。
需要保留的怀疑在性能口径上。机密计算在业界长期伴随可观的运行开销,谷歌给出的接近于零来自自家测试,发布当天没有独立基准可以对照。
8i Max把两颗芯片塞进一个封装
智能体带来的负载特征与聊天机器人不同。几十个智能体同时在一个完整代码库或数小时视频上协作时,模型要反复读取上下文,内存带宽会先于算力成为瓶颈。谷歌把这个问题称为内存墙。
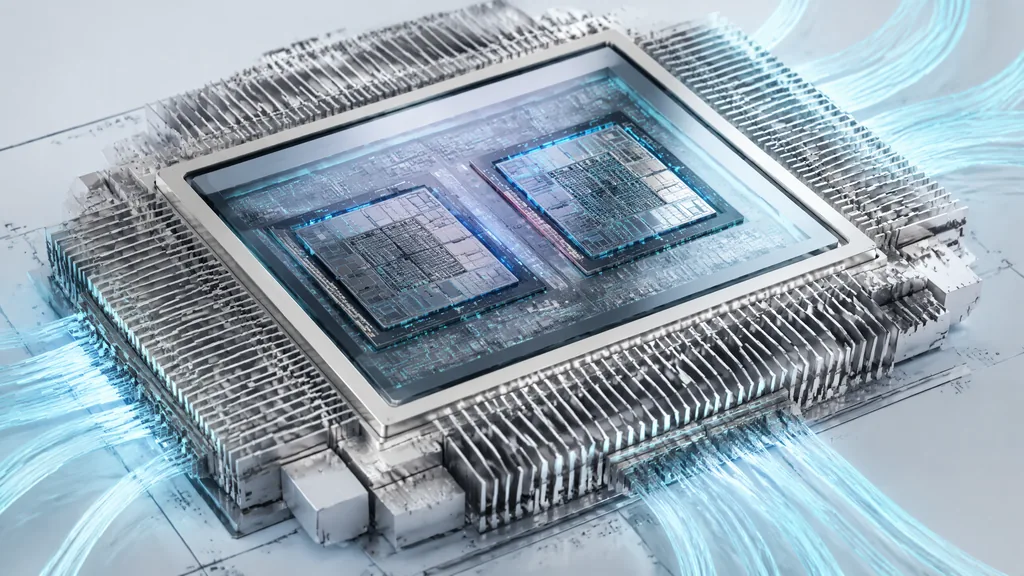
解法是把两颗低延迟的8i芯片组合到单一封装内,让算力、片上SRAM与HBM带宽同时翻倍。据TechTarget引述谷歌的数据,双芯配置的片上SRAM为768MB,HBM带宽达到17.2TB/s。更实在的一处收益在密度,同样的机柜空间里能装下两倍的硅片,单位面积与单位功耗可部署的算力随之上升。
换成日常场景去理解。一个人同时处理多少份文件,不只取决于桌子有多宽,还取决于从抽屉搬到桌面的速度。上下文窗口越长,桌面上要摊开的文件越多,取件的通道一窄,桌子再大也只能干等。8i Max加宽的是桌面和通道,不只是手速。
封装层面的代价同样存在。两颗大芯片共处一个封装,热密度上升,对散热方案和基板工艺提出更高要求,先进封装产能也一直是行业瓶颈。这些约束不会写进发布稿,却决定双芯方案能多快落到机柜里。
卖芯片之外,还要把软件搬过来
开发者不会因为一颗芯片的峰值指标换掉手里的代码。谷歌在同一篇博客里列了一串软件动作,指向的都是迁移成本。10月开源的TorchTPU让PyTorch代码与Hugging Face模型直接跑在TPU上,vLLM和SGLang也有了现成的TPU后端。处于预览阶段的开源TPU agent suite可以接入Claude Code、Cursor和Google Antigravity,用自然语言完成上手、瓶颈诊断和内核调优。开源模型状态层TPU Sync把芯片HBM、主机DRAM、共享存储与数据中心网络串成一套内存层级,按毫秒级把KV缓存卸载到芯片之外,谷歌称首字延迟与KV传输延迟的降幅超过90%。GKE动态切片借助光电路交换在现场拼装TPU拓扑,谷歌称作业启动时间最多缩短5倍,故障恢复最多加快4.5倍。
这些工具的共同作用是压低转换成本。谷歌同时披露TPU业务已有接近100家客户,涵盖前沿实验室、交易公司、零售商和高校,部分客户已把TPU部署进自有数据中心。从只出租云上算力,到把整套系统卖进客户机房,商业模式的变化比任何一项参数都更值得留意。
摩尔洞察与战略公司创始人Patrick Moorhead对TechTarget表示,目前大约三分之二的AI算力用于推理,把专用化用在推理硬件上是合理的判断。
推理占主导,意味着采购方更在意每美元能跑多少token,训练集群的峰值算力不再是唯一标尺。这个口径对专用芯片有利,也对软件栈成熟度提出了更高要求。
发布稿之外的三处空白
第一处是价格与时间。谷歌博客没有给出两款系统的售价和上市日期。财联社11月9日的报道援引Vahdat称,两款新品将于明年上市。
第二处是基准的独立性。谷歌引用SemiAnalysis的InferenceX与AgentX评测,称其vLLM-TorchTPU软件栈取得同类最优的推理性价比。这些结果由谷歌主动引用,完整测试条件与功耗数据没有随发布稿公开。
第三处是产品线复杂度。四种配置分别对应训练、低延迟推理、机密推理与超长上下文,客户要为自己真实的负载挑对型号,选型成本随之上升。系统越专用,错配的代价也越高。
竞争的重心在移动
过去十年,AI芯片的竞争集中在制程与架构。流片周期长,一代产品要管两年,厂商只能在通用性上做妥协。谷歌这一年的四次发布显示另一条路径正在成型。硅片保持相对稳定,通过封装、内存配置、网络拓扑和安全能力重组出不同系统,用几个月而不是几年来回应负载变化。
这条路径并非谷歌独有。芯片厂商都在把产品线切细,把训练与推理分开,把通用与专用分开。差别在于切片之后谁能让软件跟上。四款TPU能不能换来份额,最终取决于客户迁移代码的时间与成本,而不取决于发布稿里的倍数。